Subscribe
Topic

Data Curation

Curating training data for LLMs. Posts compare synthetic data and curation pipelines like Distilabel, NeMo Curator and Data-Juicer, and explain data filtering and deduplication with heuristics, MinHash LSH and SemDeDup.

Articles

1-2
  1. Synthetic Data Generation and Data Curation Pipelines in Production: Comparing Distilabel, NVIDIA NeMo Curator, Data-Juicer, and InstructLab

    As frontier language models exhaust human-authored web text, pretraining and post-training performance increasingly depends on automated data curation and synthetic data synthesis. Unfiltered public corpora introduce duplicate content, synthetic artifacts, low-reasoning text, and licensing liabilities. Modern foundation models, including Meta's Llama 3.1, NVIDIA's Nemotron-4 340B, Alibaba's Qwen 2.5, and IBM's Granite, are trained on datasets where synthetic generation and rigorous multi-stage f
    Data Curation
    9 min read
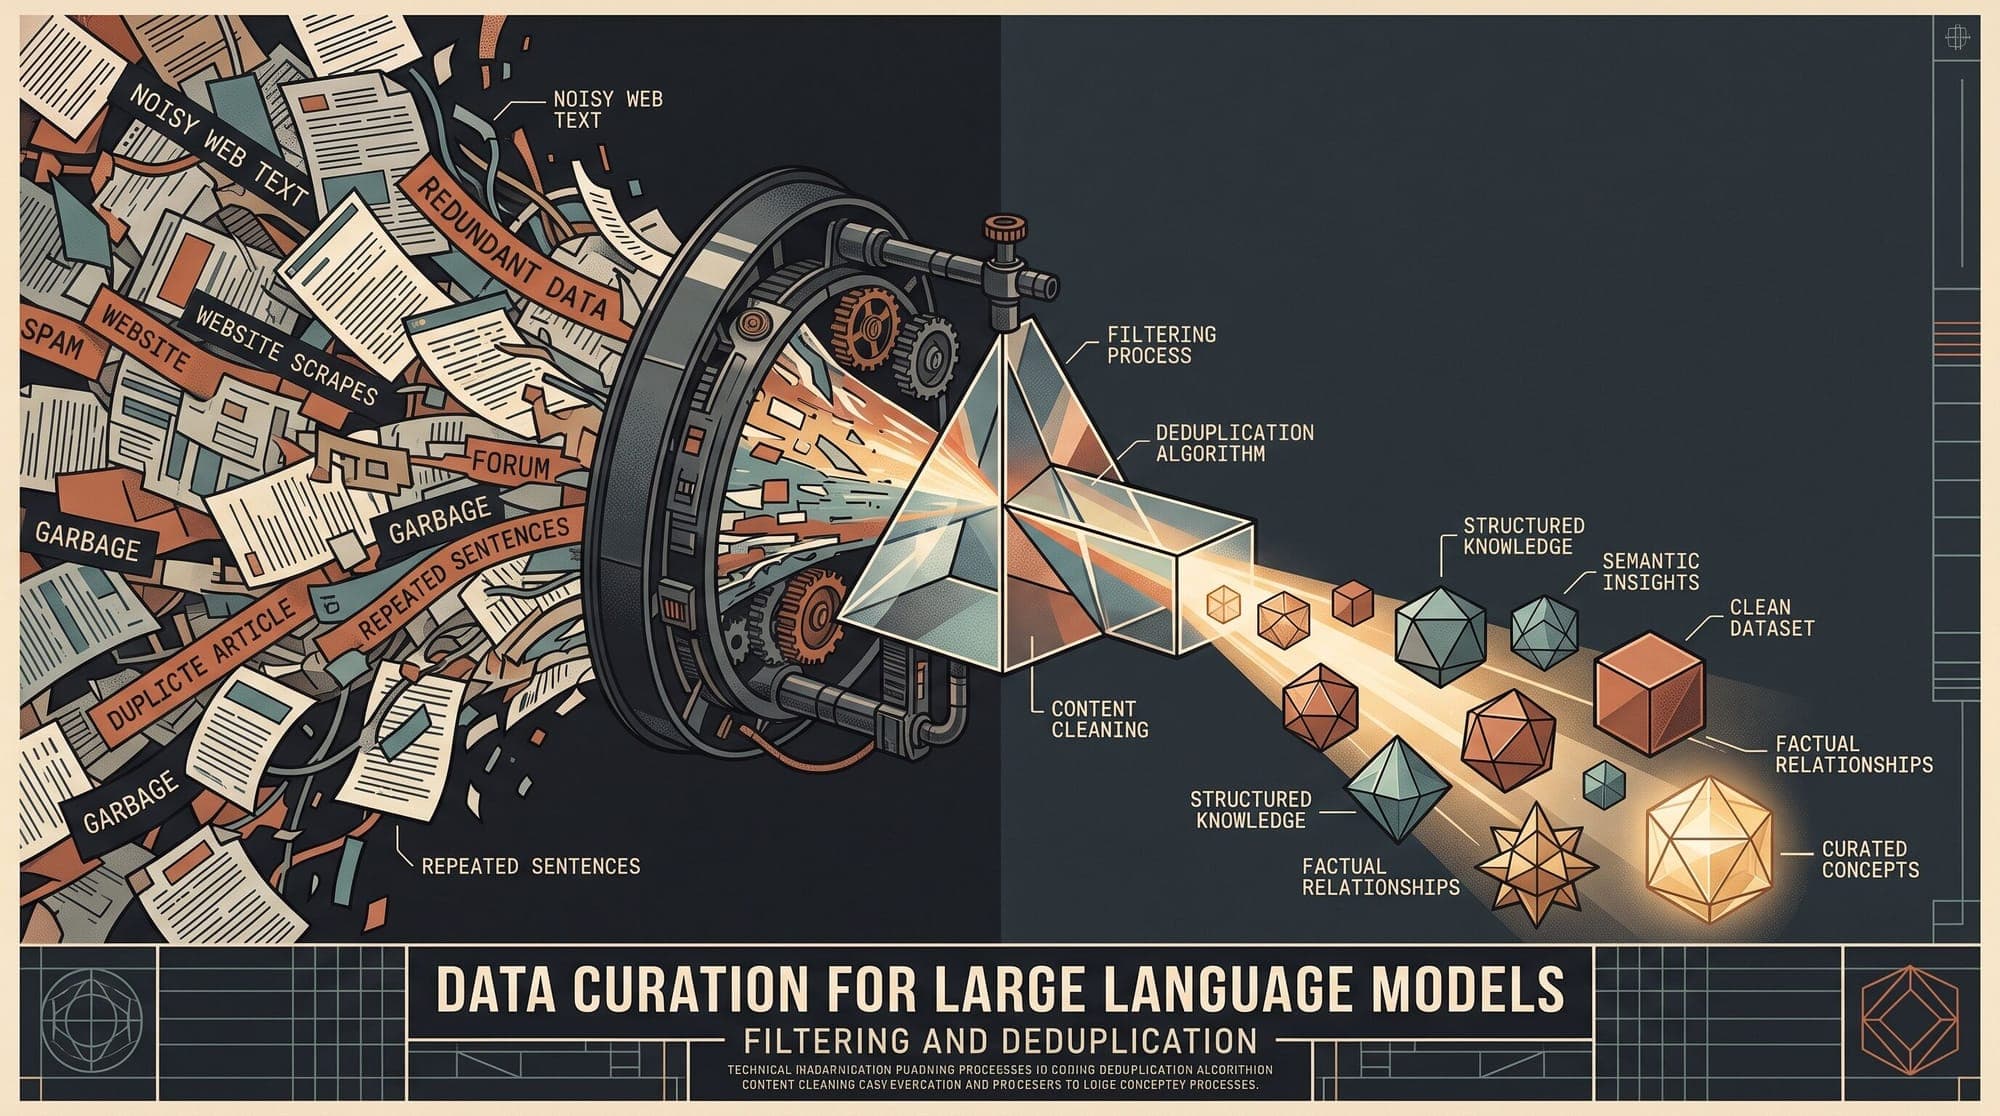
  2. Data Filtering and Deduplication in Large Language Models: How Heuristics, MinHash LSH, SemDeDup, and Quality Classifiers Curate Pre-Training Corpora

    Data Filtering and Deduplication in Large Language Models: How Heuristics, MinHash LSH, SemDeDup, and Quality Classifiers Curate Pre-Training Corpora Pre-training data quality governs the downstream reasoning, factual accuracy, and sample efficiency of foundation large language models (LLMs). While early pre-training efforts relied on uncurated or lightly processed dumps from web repositories like Common Crawl, modern state-of-the-art models depend on multi-stage data curation pipelines that fi

    AI
    10 min read