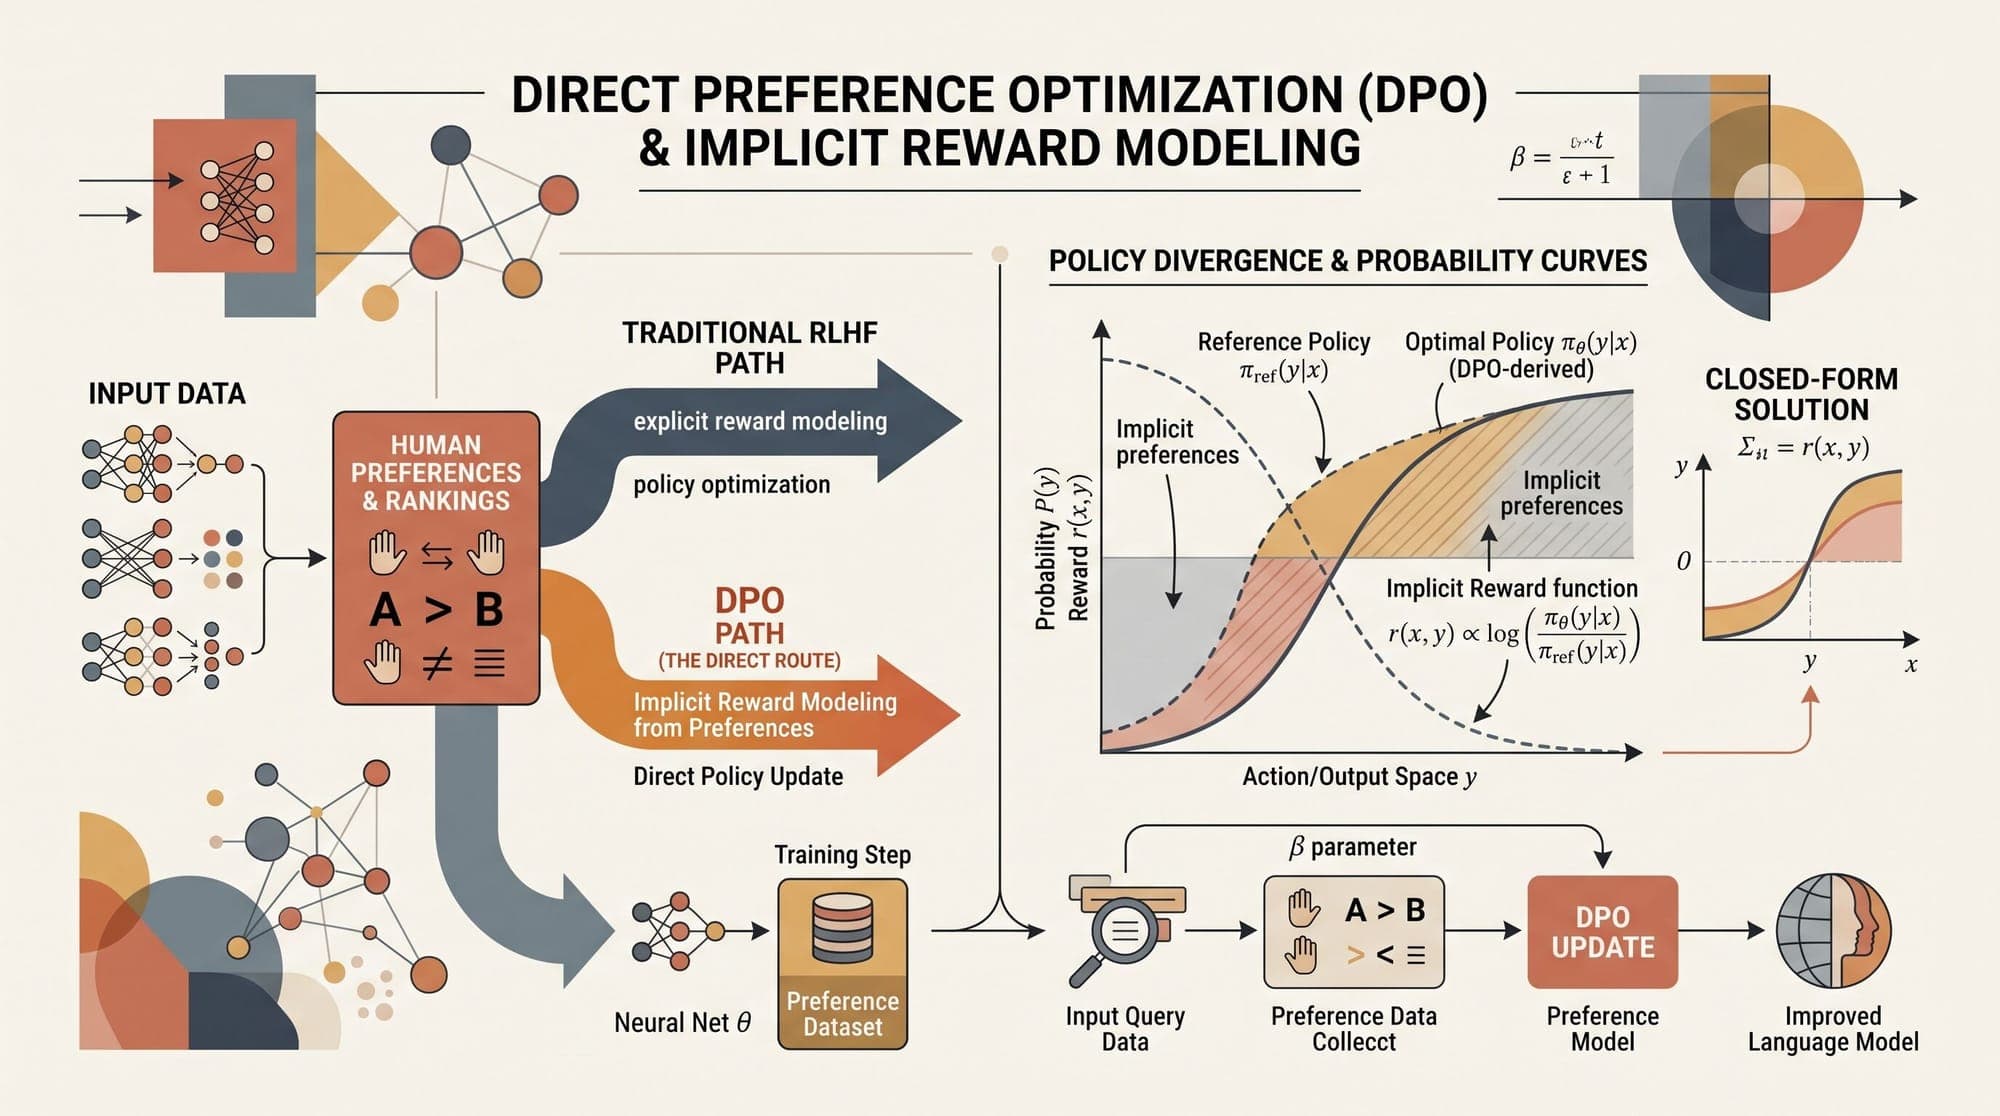
Direct Preference Optimization (DPO): Mathematical Foundations, Implicit Reward Derivation, Closed-Form Bradley-Terry Equivalence, and Reference Policy Regularization
Direct Preference Optimization (DPO): Mathematical Foundations, Implicit Reward Derivation, Closed-Form Bradley-Terry Equivalence, and Reference Policy Regularization Post-training preference alignment is the central mechanism for transforming pretrained base large language models into instruction-following, steerable, and safe conversational agents. Historically, the dominant paradigm for preference alignment has been Reinforcement Learning from Human Feedback (Christiano et al., 2017; Ouyang