LLM Evaluation Frameworks in Production: Comparing DeepEval, Ragas, Promptfoo, and TruLens Architecture, Synthetic Data Generation, Judge Calibration, and CI/CD Automation
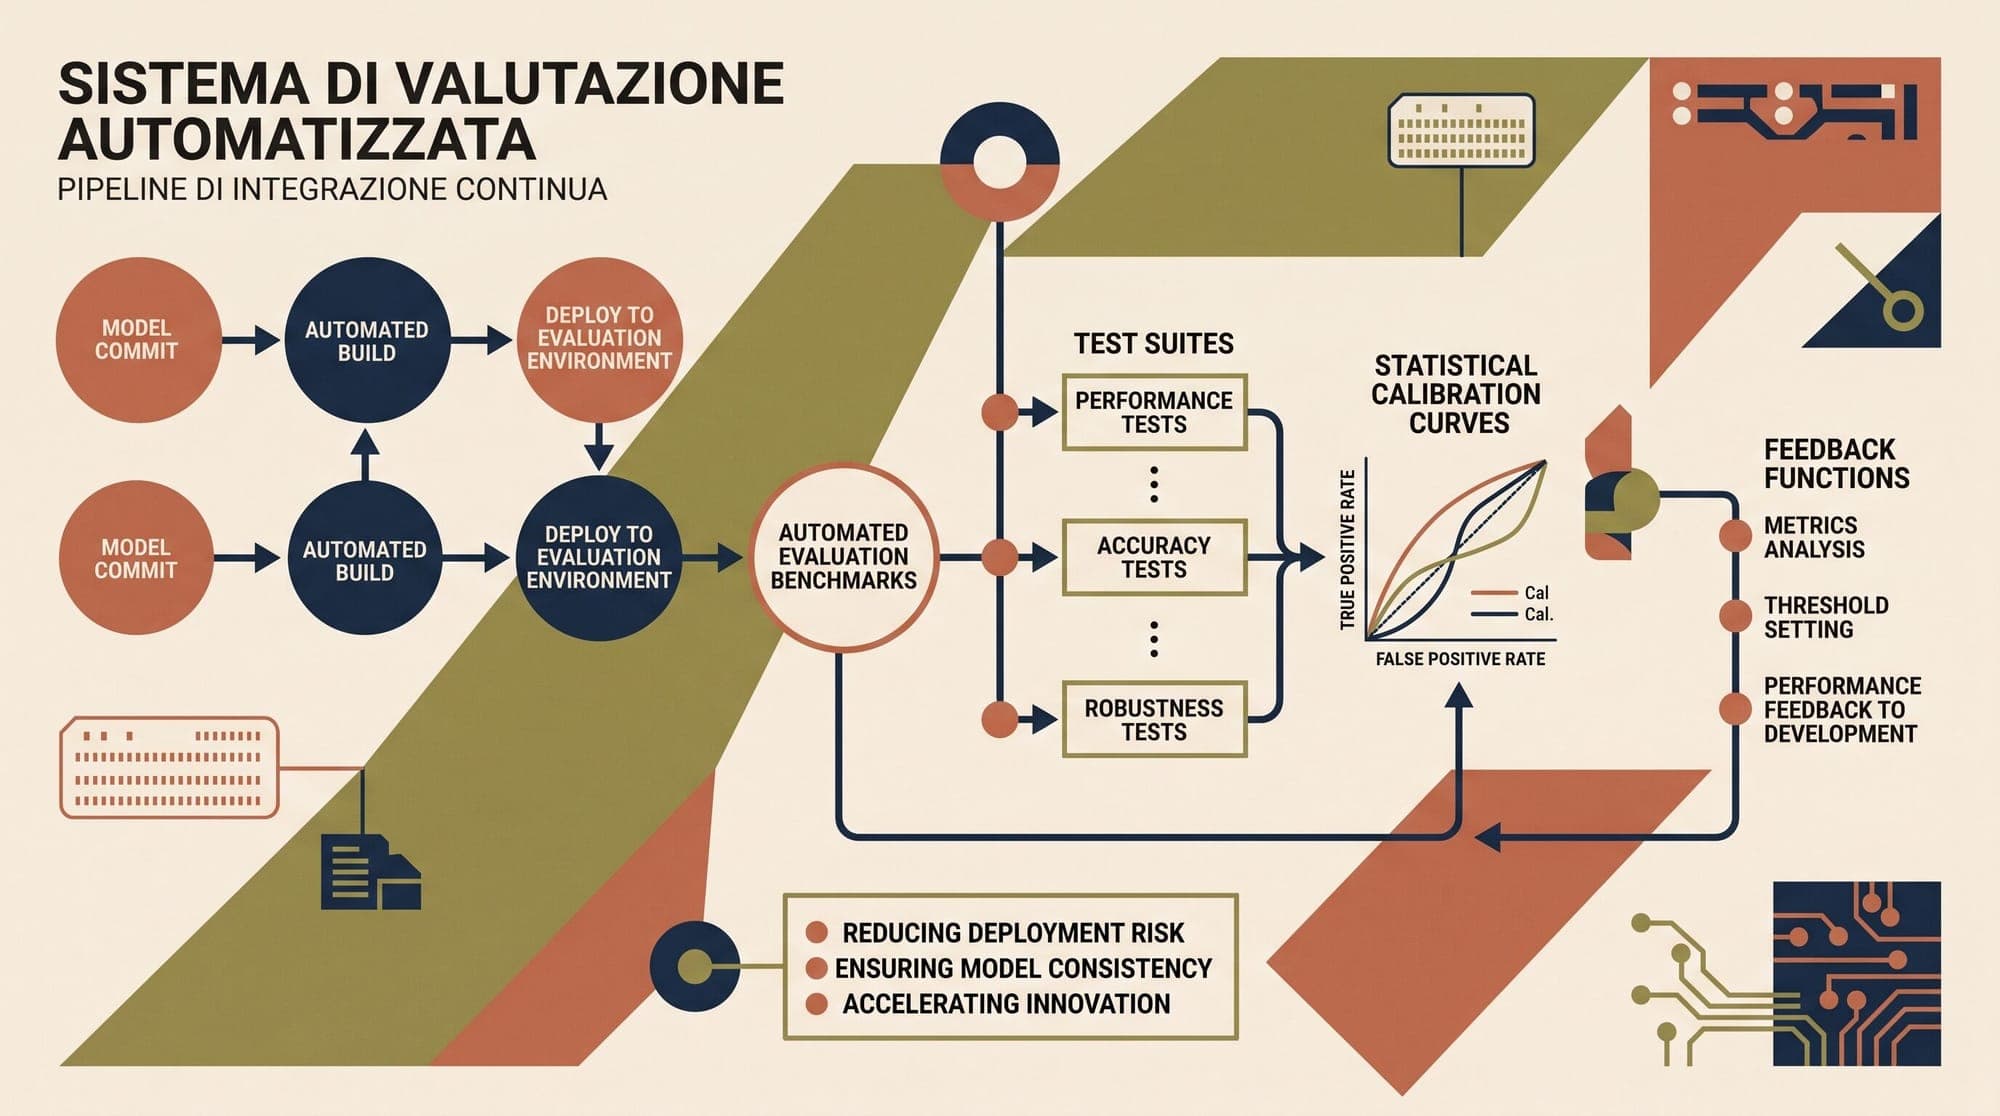
Automated evaluation is the primary engineering bottleneck in deploying reliable LLM applications. While traditional software engineering relies on deterministic unit and integration tests with binary pass/fail conditions, generative AI systems produce non-deterministic, open-ended natural language outputs. Relying on manual human review or ad-hoc prompting fails to catch regressions across prompt modifications, model version updates, and retrieval pipeline adjustments. To establish rigorous qu