Subscribe
Topic

Performance

Measuring and improving LLM performance in production. Posts explain continuous profiling with roofline models and model FLOPs utilization, token budget allocation for dynamic context assembly, and FP8, INT8 and INT4 quantized KV caches.

Articles

1-2
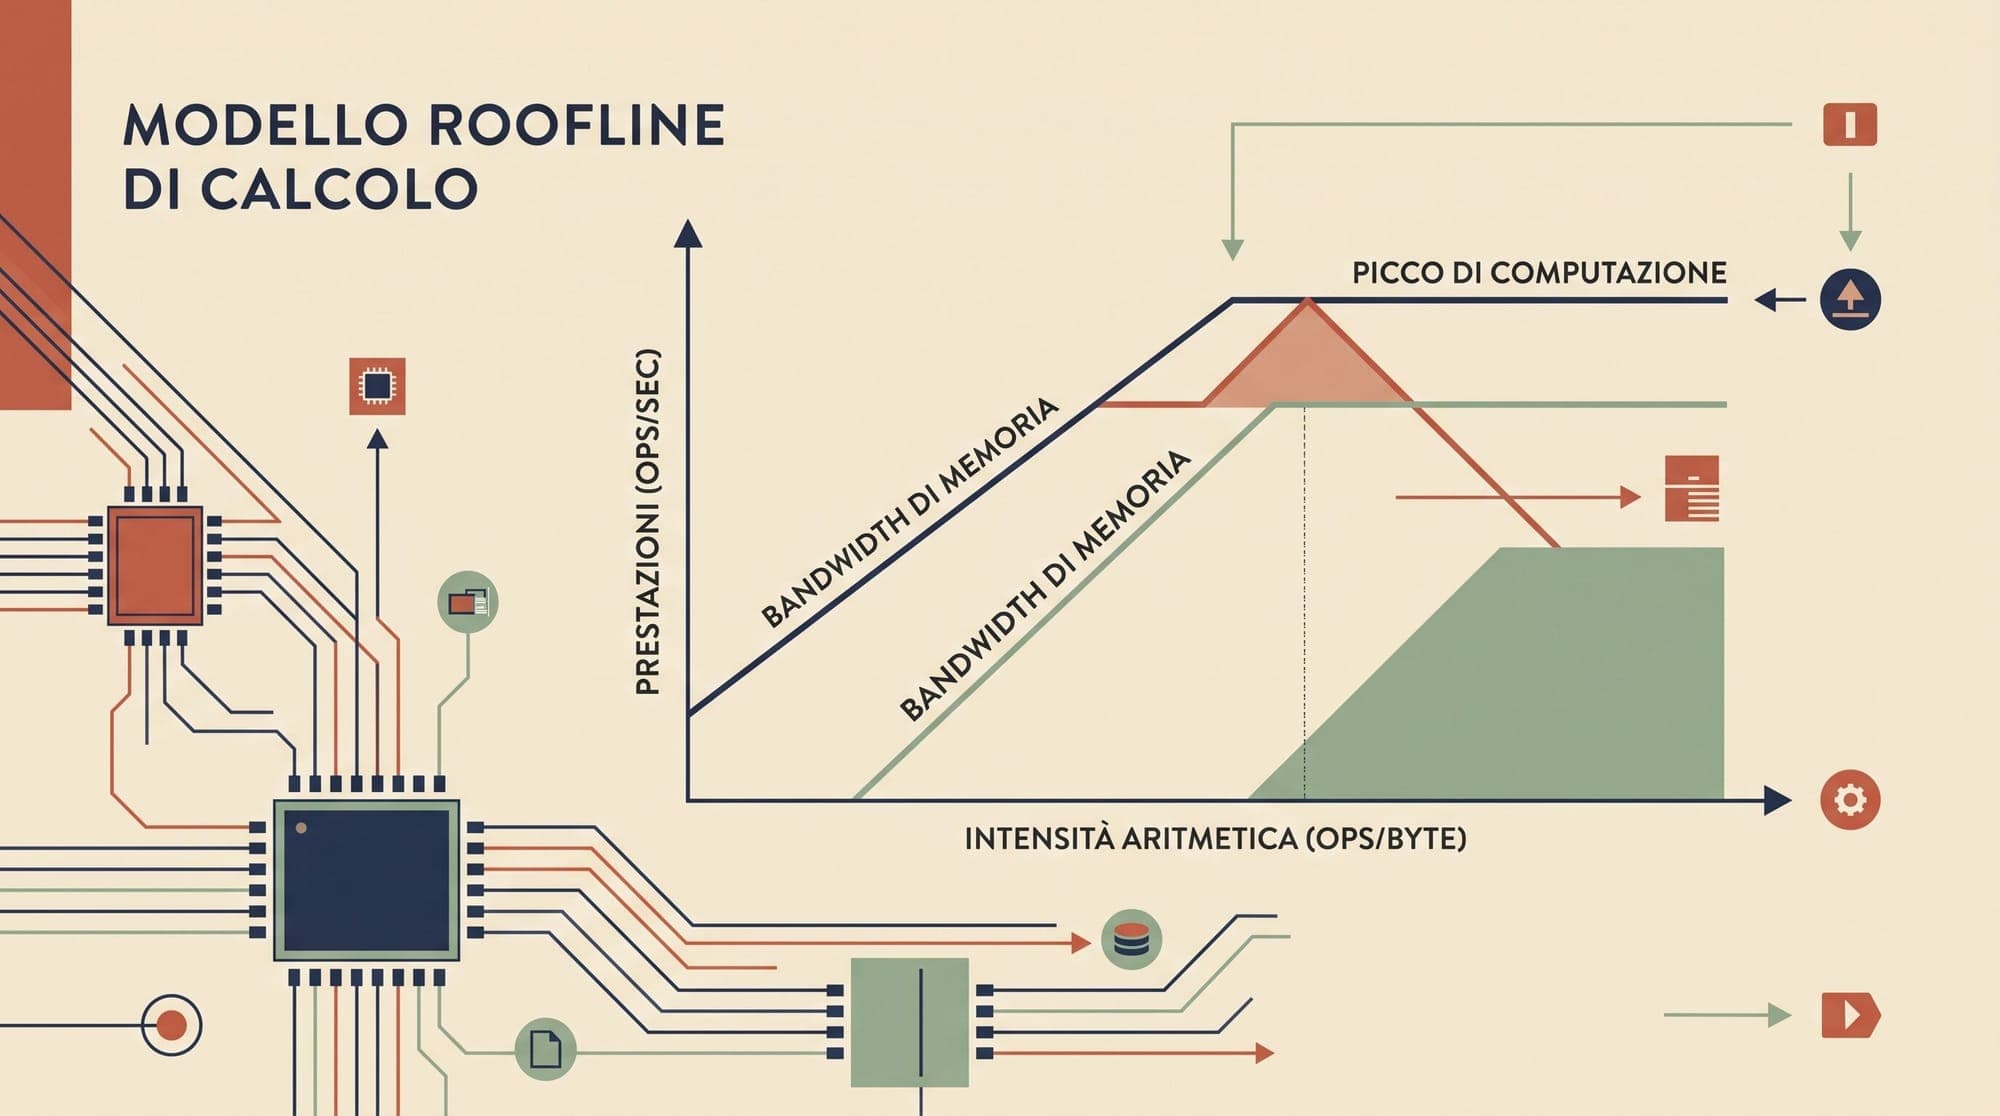
  1. Continuous LLM Performance Profiling in Production: Roofline Models, Model FLOPs Utilization, Model Bandwidth Utilization, and Hardware Bottleneck Diagnostics

    Evaluating the runtime performance of large language model serving infrastructures requires looking beyond raw GPU metrics. Standard operating system utilities such as nvidia-smi report high GPU utilization percentages whenever compute cores or memory controllers are active, masking critical inefficiencies in memory access, communication, and kernel scheduling. A serving node running single-stream autoregressive decoding can report 100% GPU utilization while operating at less than 2% of the hard
    AI
    7 min read
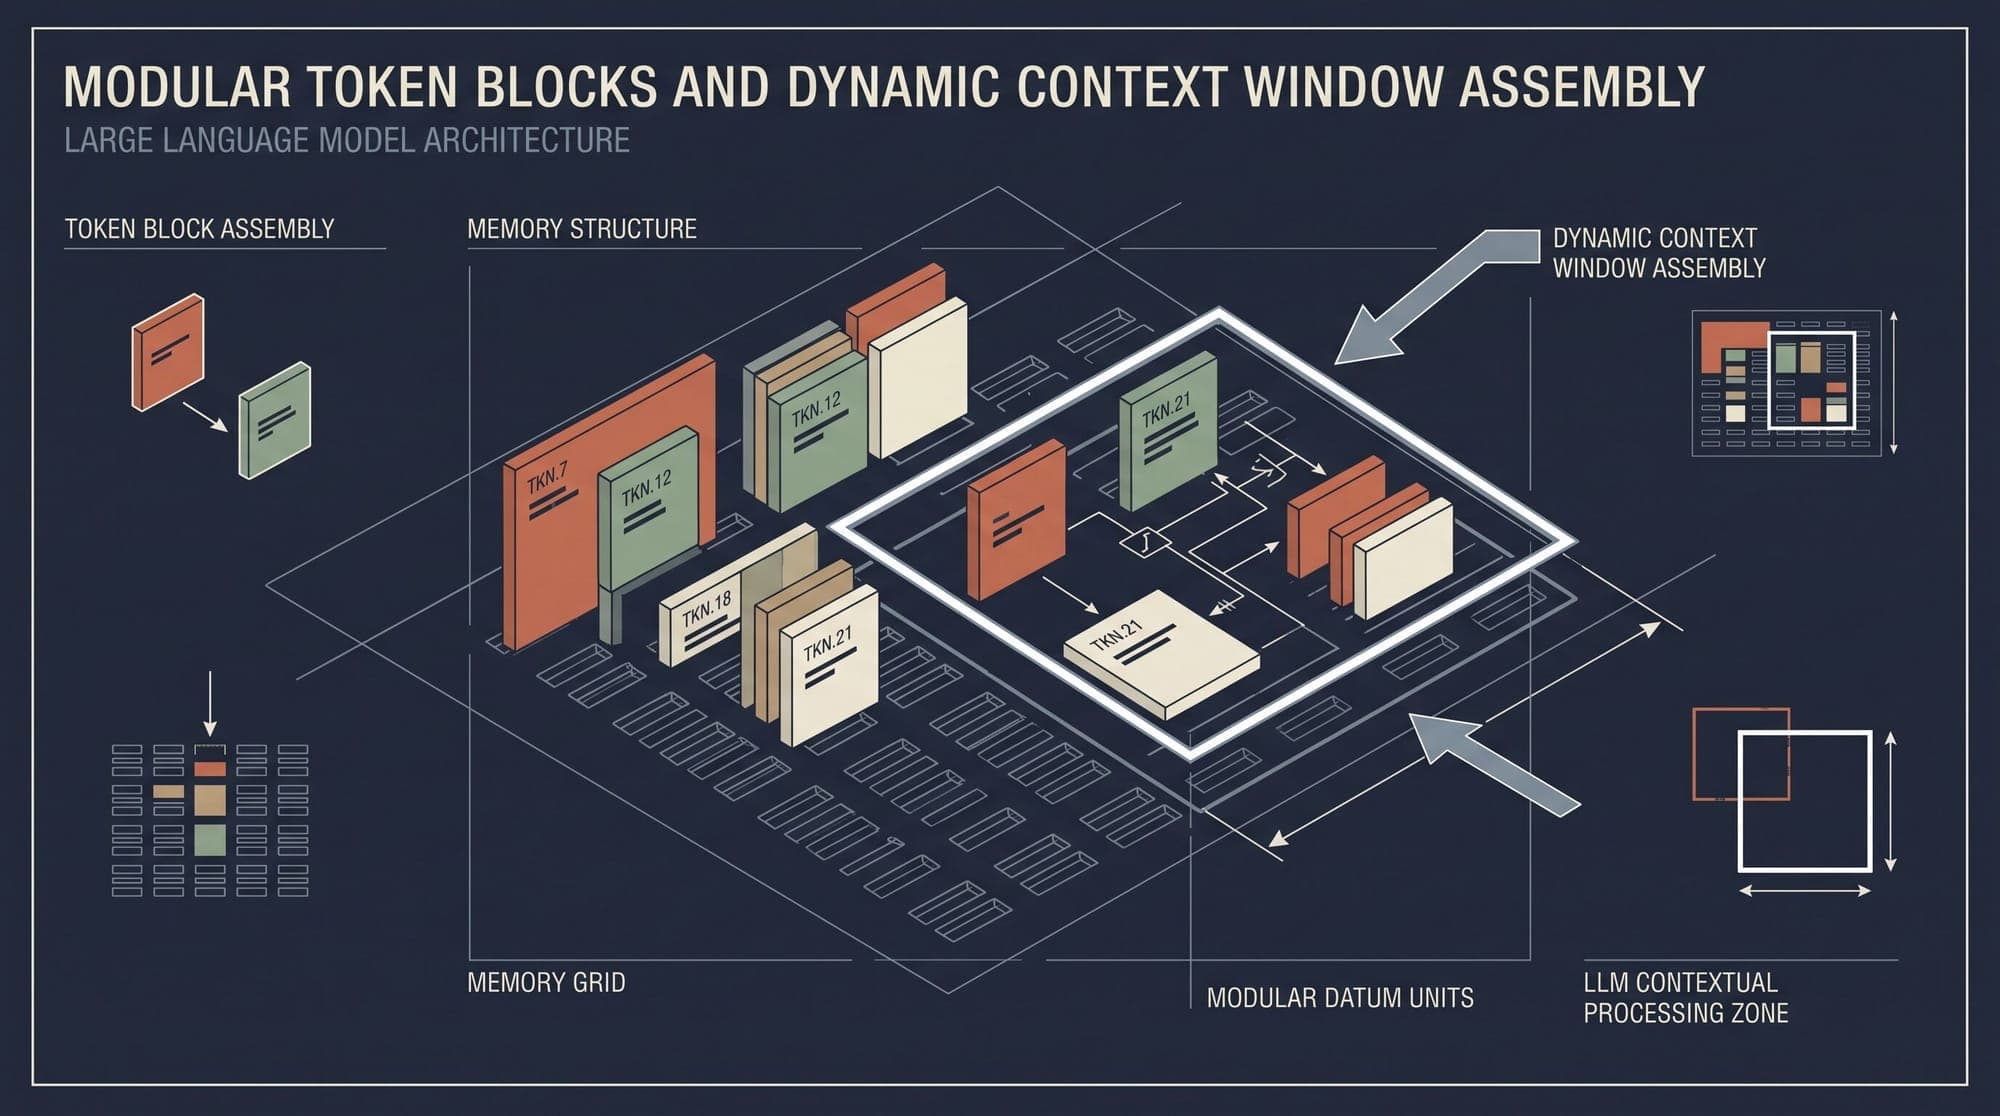
  2. Dynamic Context Assembly and Token Budget Allocation in Production: Priority Packing, Prefix Cache Alignment, and Degradation Fallbacks

    In production large language model systems, prompt construction is frequently treated as simple string concatenation. Engineers assemble system instructions, tool schemas, retrieved document snippets, memory state, and multi-turn conversational history using template strings. In low-throughput prototypes, this approach functions adequately. In high-throughput production systems and multi-agent workflows, naive assembly introduces critical failure modes: abrupt context window overflows triggering

    LLM
    6 min read